我是如何借助 AI 制作一支长视频的
这篇也做成了一条 32 分钟的视频《全网 150 万播放的 AI 动画,怎么做的?分享我的制作全流程》,可以在 B 站看。
现在的 AI 能做出什么
上一条我和 AI 制作的视频,获得了全网 150 万的播放,很多人问我是怎么做的,46 分钟的视频要烧多少 token,花了多长时间,用什么工具。。。这篇我会毫无保留地分享,我是怎么借助 AI,把这样一条长视频做出来的。
其实只要你最近刷视频比较多,就会发现各大平台上出现了大量制作精美的知识科普视频,其中很大一部分,都是 AI 做的,其中不乏有博主在短短一个月内达到几万甚至几十万的粉丝数。
在今年诺贝尔奖公布后的半天里,网上就冒出了大量 AI 做的诺奖科普,以往要做几天的科普视频,现在被 AI 压缩到小时级别。
找了几个科普视频作为参考:
| 斗转星移《幸存者偏差》 | burgun物理《26 诺贝尔化学奖是什么?》 | 无足鸟《2026诺奖·中微子》 | 毕导《不做诺奖科普的第一年》 | Iwanau《运气的形状》 |
|---|---|---|---|---|
| 抖音 #vibe知识大赏 话题里最早一批爆款,同题 42 个版本里它最早发,69 万赞 | 诺奖公布第二天,用「左手和右手长得一样吗」开头,40 万赞 | 诺贝尔奖公布当天发出,39 万赞 | 人类博主的自嘲:「AI 一发力,我这个人类科普博主直接没活了」 | 高尔顿板,后面我们拿它做同题实验 |
现在 AI 制作科普、宣传品等动效视频的效率和质量已经很夸张了。尤其是 Opus 5.5 在讲知识、控节奏等方面也能做的非常好,画面也做得漂亮,这些视频能拿到高播放量一点也不奇怪。
实际上 AI 确实很适合做这种概念科普短片。科普这类题,天然落在 AI 擅长的几处:
- 知识是现成的,它检索、整理得快;
- 讲法有章可循,概念、例子、结论,它顺着就能讲成故事;
- 画面多是图表、示意和数字,正是写代码最拿手的;
- 对错可以核对,它还能自己查一遍。
这些要素全齐了,人需要干预的地方很少,因此一句话就可以生成七八十分的作品。
当然也有人愿意花更长的时间去打磨短片,因为制作人有自己的审美,想让 AI 做出来的东西更符合自己的想法,就需要对制作流程有更多的把控,反复打磨制作出 90 分的作品。
我相信这部分大家在看各种作品时就能明显感受到,因为我最近也在平台上看到了不少用 AI 制作的画面精美、叙事流畅、节奏明快、创意新奇的视频,它们和一句话做出来的片子,差就差在制作人肯花多少心思去打磨。
再比如我上一条视频有四十多分钟,我在上面花了大量的精力,因为长视频光靠简单的几轮对话是做不出来的,内容越长,就越需要人的把控。
所以这篇我分成了两部分。先讲科普短片一般是怎么做成的,通过一句话加一点准备,AI 就能做出一条不错的片子。第二部分再讲长视频,我那条四十多分钟的片子是怎么一步步做出来的,用了哪些工具,在哪些地方栽过。不会剪辑,不会用 Blender 这种工具也没关系,因为我也不会。
一、短片,一句话就够
AI 是怎么做出一个画面的
先说画面是怎么来的。最近爆火的这些科普动画,大多不是视频模型「生成」出来的,是 AI 写代码画出来的。
二维的有网页 Canvas(浏览器里的画布)、Remotion(用网页代码做视频的框架)、Manim(3Blue1Brown 做数学动画用的库)这些;三维常用的有 Blender、Cinema 4D、Houdini,我用的是 Blender,免费开源,还能整个用 Python 脚本控制,最适合交给 AI。实际上这些我们都不用学习具体的操作,只需要让 AI 自己分析需要什么工具,使用什么 skill(别人打包好的一套做法),让它下载、安装、运行就行了,我们只用给出目标。
比如我之前视频的 3D 效果最终选择 Blender 渲染,Claude 会写 Python 脚本,在后台自己默默建模型、配材质、打灯、摆相机,最后把画面渲出来。那条 46 分钟的视频光动画引擎就有一千七百多行,各章的关键帧脚本(每个镜头摆什么、怎么动)加起来一万行出头,全都是 AI 写的。 每个静态画面,方块多高、相机转多少度、哪个元素什么时候出现,在代码里都是一个具体的数。我说哪里要调整,AI 就去改那部分代码,其它地方不会被误伤,同样的代码,同一个时间点每次渲染出来都能保证同一张图。
画面是代码算出来的,就有另一个很大的好处,就是试错成本低,迭代快。指出问题之后一轮就能修复好,它渲染起来比视频生成还快,我说完哪里要改,过一会就能看到新的画面。而且现在绝大部分模型支持图片,因此 AI 自己还能看渲出来的图,先挑一遍毛病,所以很多地方我只要说一次,AI 就会自行修改然后 review 几轮,最终交付给我修复好的版本。
画面能做出来了,接下来的问题是:做成什么风格?
风格从哪来:找参考,让 AI 拆了再仿
为什么先讲风格?一条科普片吸不吸引人,大致看三样:画面风格决定观众第一眼停不停下来,节奏决定他能不能看完,内容决定看完有没有收获。内容上 AI 已经很拿手,前面说过了;风格和节奏,恰好都能从参考片里拆出来:动效怎么动、多久换一个画面、哪里停下来留白,都藏在一帧帧画面里。所以这一节讲风格,节奏也一起拆。
视频的风格从哪来?最省事的办法是找参考。下面是我调研时收集的几种 AI 做出来的风格:
| 深色信息卡 | 工程蓝图 | 等轴信息图 | 水墨 | 一笔画 | 拼贴和无限变焦 | 写实和视频模型 |
|---|---|---|---|---|---|---|
| 《Room to Think》 | 《Patent Pending: The Cloud Catcher》 | 《From Bean to Cup》 | 《The Swordsman and the River》 | 《The Line That Never Lifted》 | 图像模型画风景、视频模型做人和鲸、代码做视差和缩放 | 虚构主持人跨场景保持一致的纪录片 |
前五条样片 © LemoLab,来自 Lemo-Opuscar,CC BY 4.0,此处为节选。
除了这些现成的风格,你也可以给 AI 一条你喜欢的视频,它能一帧一帧地分析,告诉你:
- 里面用了哪些动效、每个动效叫什么、怎么动的
- 整条片子是什么风格
- 配色、字体用的是什么
- 镜头、节奏是怎么把控的
然后它就会照着这份拆解,做一条讲你自己内容的新视频。风格定下来,后面做科普视频就简单多了。你会发现很多博主前后发的视频,风格都很接近:有了一套固定的风格,后面就很容易做出相似的内容、相似的效果。
这里介绍下 AI 是怎么拆解视频的,关键在抽帧:Claude 看不了视频,只能看图片,所以要先把视频变成一张张图,这一步就叫抽帧。抽法有这么几种:
- 几分钟的短片,直接让它每秒抽几张,从头看到尾就行
- 片子很长,但你知道要学的是哪一段,就告诉它时间点,让它把前后那一段密密地抽出来
- 不知道该看哪儿,就让它自己找:先隔几十秒抽一张,看看整部片子讲了什么,再算出哪些地方画面变化最快,把那几段单独抽密,连起来看动作是怎么接上的、镜头什么时候转。片子长的话,粗看这一步可以交给便宜的模型
- 有弹幕就更省事,观众反应最集中的地方,就是最值得细看的
长片我实际是把后两种合在一起,分三步:
- 先每隔十几秒抽一张,配着字幕过一遍,知道这条片子讲了什么、画面大概什么样
- 再让 AI 逐帧算前后两帧差多少,把画面变化快的地方标出来,挑出要学的,把前后几秒到几十秒密密地抽出来细看
- 有弹幕的话,最后把弹幕最密的几处也拉出来,那是观众反应最集中的地方
按画面变化挑出来的片段有个最短时长,一闪而过的转场会被漏掉,这种还得人补看一眼。
以有知有行这部《投资是怎样赚钱的?》(也是我上一条视频的画面参考)为例,AI 拆一条参考片,可以从中学到这些内容:
| 手法 | 是什么 | 画面 |
|---|---|---|
| 引导物 | 一个贯穿的小东西(比如一个光点)带着观众的视线换场景,代替硬切 | 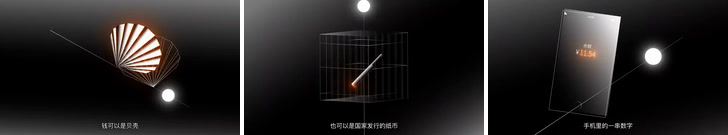 |
| 嵌套拉远 | 上一幕整个缩小,变成下一幕里的一个零件 | 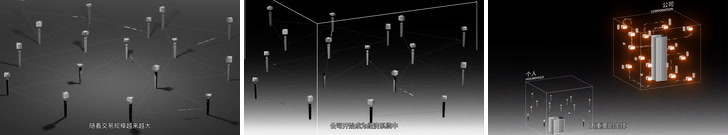 |
| 3D 转 2D 对位转场 | 镜头转到正面的同时,场景里的线变成图表网格,物体变成数据点 | 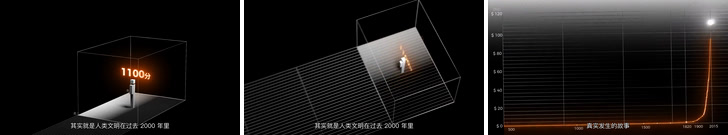 |
| 背景明暗切换 | 黑底换白底,标记一个段落或情绪的转折 | 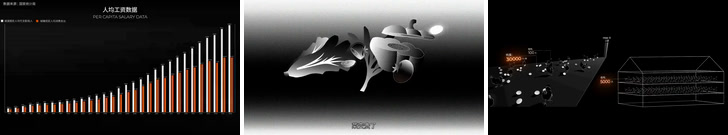 |
| 价签滚动 | 数字落在实物上滚动变化,让数字有了重量 | 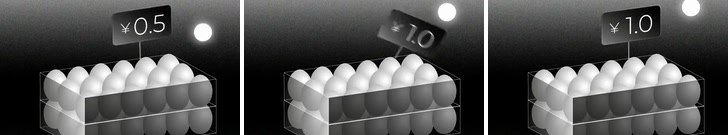 |
| 节奏 | 多久换一个画面、一句字幕停几秒、哪里停下来留白;比如开头说的一个月涨到几十万粉的 B 站账号「比特新语」,每 2 到 3 秒换一句字幕;图里有知有行这一段更快,三句字幕每句只停一秒多 | 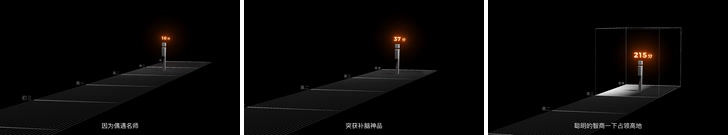 |
| 镜头只在变形时动 | 讲解时镜头不动或极慢推进,动的是物件;大幅运镜只留给「一个东西变成另一个东西」的时刻 | 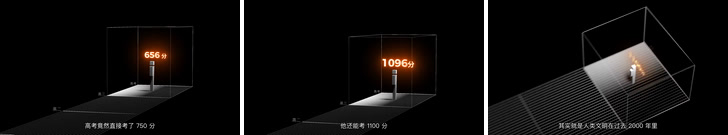 |
我上一条视频的画面,就是这么学来的。比如参考视频里弹幕刷「这一段动画直接炸裂」的那几秒,我让 AI 拆出了里面的转场手法,再照着做出了我们自己的镜头,其他优质的动效片段我也让 AI 截取了下来,放进我们的参考库,这样后续 AI 就可以从这里面去学习。
这个视频里就是 AI 模仿的结果:前几秒是有知有行的原片(03:22 起),中间定格,标出 AI 拆出来的手法「3D 转 2D 对位转场」,最后是 AI 照着做出来的开场那一镜。
除了拆参考片之外,另一条常见的路是装 skill,也就是别人打包好的一套画法。我这里用同一套字幕,让 AI 各做了一版讲「运气的形状」的科普视频:6 种不同风格、7 个 skill,再加一版不装 skill 作对照,一共十四版。
为了便于对比,这十四版拿到的是同一套材料:同样的 11 条字幕、同一张时间表、同一段配乐,只有字幕和配乐,不配音。大概这样:
一组只换风格:
| 风格 | 一句话说明 |
|---|---|
| 手绘白板 | 白板马克笔逐笔画出来,最多三种笔色,线条一直微微抖动 |
| 扁平 MG | 纯色大色块撞色,物体几何化,几乎不描边,元素带弹性地进出 |
| 水墨 | 宣纸上的写意水墨,墨分浓淡,只用一点朱砂 |
| 像素风 | 大颗粒像素、硬边缘、有限色板,低分辨率画布整数倍放大 |
| Blender 3D | 棚拍质感的 3D,真实材质、柔光、浅景深,用 Blender 渲染 |
| 3b1b 式 | 深蓝黑底,左上角固定标题,逐步推导 |
一组只换 skill:
| skill | 怎么做的 | 链接 |
|---|---|---|
| 不装 skill | 对照组,手写 Canvas 2D 脚本,逐帧截图 | |
| Manim | 一幕一个场景,共 5 幕,分幕点卡在字幕起点 | Yusuke710/manim-skill |
| Remotion | 建 React 工程,每个场景一个组件,动画全由帧号驱动 | remotion-dev/skills |
| HyperFrames | 先写 5 帧分镜,5 个子 Agent 各做一帧,再组装 | heygen-com/hyperframes |
| Anatomy | 把高尔顿板画成一台等轴视角的机器 | wheresryan22/anatomy |
| Onetake | 一镜到底,钉子原地变成三角形里的数,再变回钉子(不能商用) | feitangyuan/onetake |
| Lemo-Opuscar | 铅笔在奶油色纸上画图表,带手写注 | lemomo-ai/lemo-opuscar |
| Anidoodle | 黑板风格,用粉笔一笔笔写出来 | alexgreensh/anidoodle |
这是最终的结果,里面有一些风格其实并不适合这个主题,但是你可以从这里面能够看到不同的风格和 skill 的效果是怎么样的:
六种风格
七个 skill 和不装 skill 的对照
想细看哪一版,可以在这里单独打开:
| 手绘白板 | 扁平 MG | 水墨 | 像素风 | Blender 3D | 3b1b 式 | 不装 skill | Manim | Remotion | HyperFrames | Anatomy | Onetake | Lemo-Opuscar | Anidoodle |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
但其实不用记住这么多风格,只要知道 AI 能用代码做出各种各样的风格就够了。真要做视频的时候,现场去网上找一条可以参考的就行。
另外我也测了一组更发散的:只给一句话的提示词,让它自由发挥。这时候也会发现,同一句提示词,每次做出来的都不一样。
| 简历作品 · 第1次 | 简历作品 · 第2次 | 克拉尼图形 · 第1次 | 克拉尼图形 · 第2次 | |
|---|---|---|---|---|
给它的提示词就这两句:
简历作品:你是世界顶级的动效设计师,现在做一支 30 秒的作品当你的简历,拿出你全部的本事:这支片子要发在抖音和 B 站,前 3 秒让刷到的人停下来,看完,还想转给别人。
克拉尼图形:做一支 45 秒的动画,讲清楚声音为什么能把沙子排成图案(克拉尼图形),画面拿出你最炫的本事:这支片子要发在抖音和 B 站,前 3 秒让刷到的人停下来,看完,还想转给别人。
其实看到这你就会发现,这种一句话出片的效果已经在七八十分了,毕竟短片要的东西其实不多:说清楚讲什么,再给一个风格参考,剩下的它自己能做完。
下面分享一下,我是怎么做一支短片的。
如何一句话做一条科普短片
从刚才这几组示例能看出来,做一条几分钟的科普短片,需要的东西很少:
- 一个会写代码的 AI 助手,我用的是 Claude Code,换成 Codex 也可以;
- 再告诉它你想讲什么,想要什么样的画面。
写文案、做画面、渲染成视频,它都能自己做完。要配音的话,直接问它怎么配就行,它会根据你手上现有的条件判断,要不要去注册什么服务、用哪个接口,甚至也可以直接操作你的电脑完成注册流程,这一点不用担心。
具体怎么给 AI 提需求,有两种办法。
第一种最简单,直接用提示词让它做,讲一个概念,或者做一条宣传片都行。对 Opus 5.5 来说,不用专门装什么 skill,直接问就行;有些模型做动画没那么拿手,可能就需要用到之前提到的那些 skill。
下面几条都是别人公开过的完整提示词,可以自行尝试效果:
| 宝玉《什么是 Transformer》 | Tz《Password 与 Passkey 有什么区别》 | WY《中华五千年历史》 | Deedy《IKEA 说明书变三维安装教程》 |
|---|---|---|---|
| 帮我用js制作一个视频,主题是:什么是 Transformer 要深入浅出,让高中生也能看得懂,不仅high level说的清楚,也要有细节,包括注意力机制,甚至一些数学概念 你可以用任何工具或者安装工具,可以联网检索 请给我惊喜 | 给我一个可互动交互动画页面,讲解清楚 password 和 passkey 到底有什么区别,也包括它们的历史沿革,把它制作成一个小白也能看懂的讲解视频 | 做一个动画,快速回顾中华五千年的历史。风格轻松有趣,动画格式为线稿,添加合适的音乐,请务必做到引人入胜 | Translate this IKEA assembly manual into a 3D narrated instructional video (把这份宜家组装说明书做成一条带旁白的三维安装教学视频) |
第二种,你想要自己的风格,就按前面说的,挑一条喜欢的片子当参考交给 AI;做出一条满意的以后,后面的片子都可以拿它当参考。
参考从哪找?最直接的,是你平时在抖音、B 站、X 等平台上刷到,觉得好看的那些,我在整理过程中也收集了几个开源项目:
- Awesome AI Motion 上收录了一千多条用 AI 做的动画作品,并且已经按题材分好类,能直接播放,不少条目还附了原作者的提示词和源码。
- awesome-opus5-5-videos 收录了七百多条用 Opus 5.5 做的视频,附作者公开的提示词或原帖,其中四百多条可以在 Skillry 上看到别人使用同一段提示词重做的版本,可以直接借鉴对应提示词和视频。
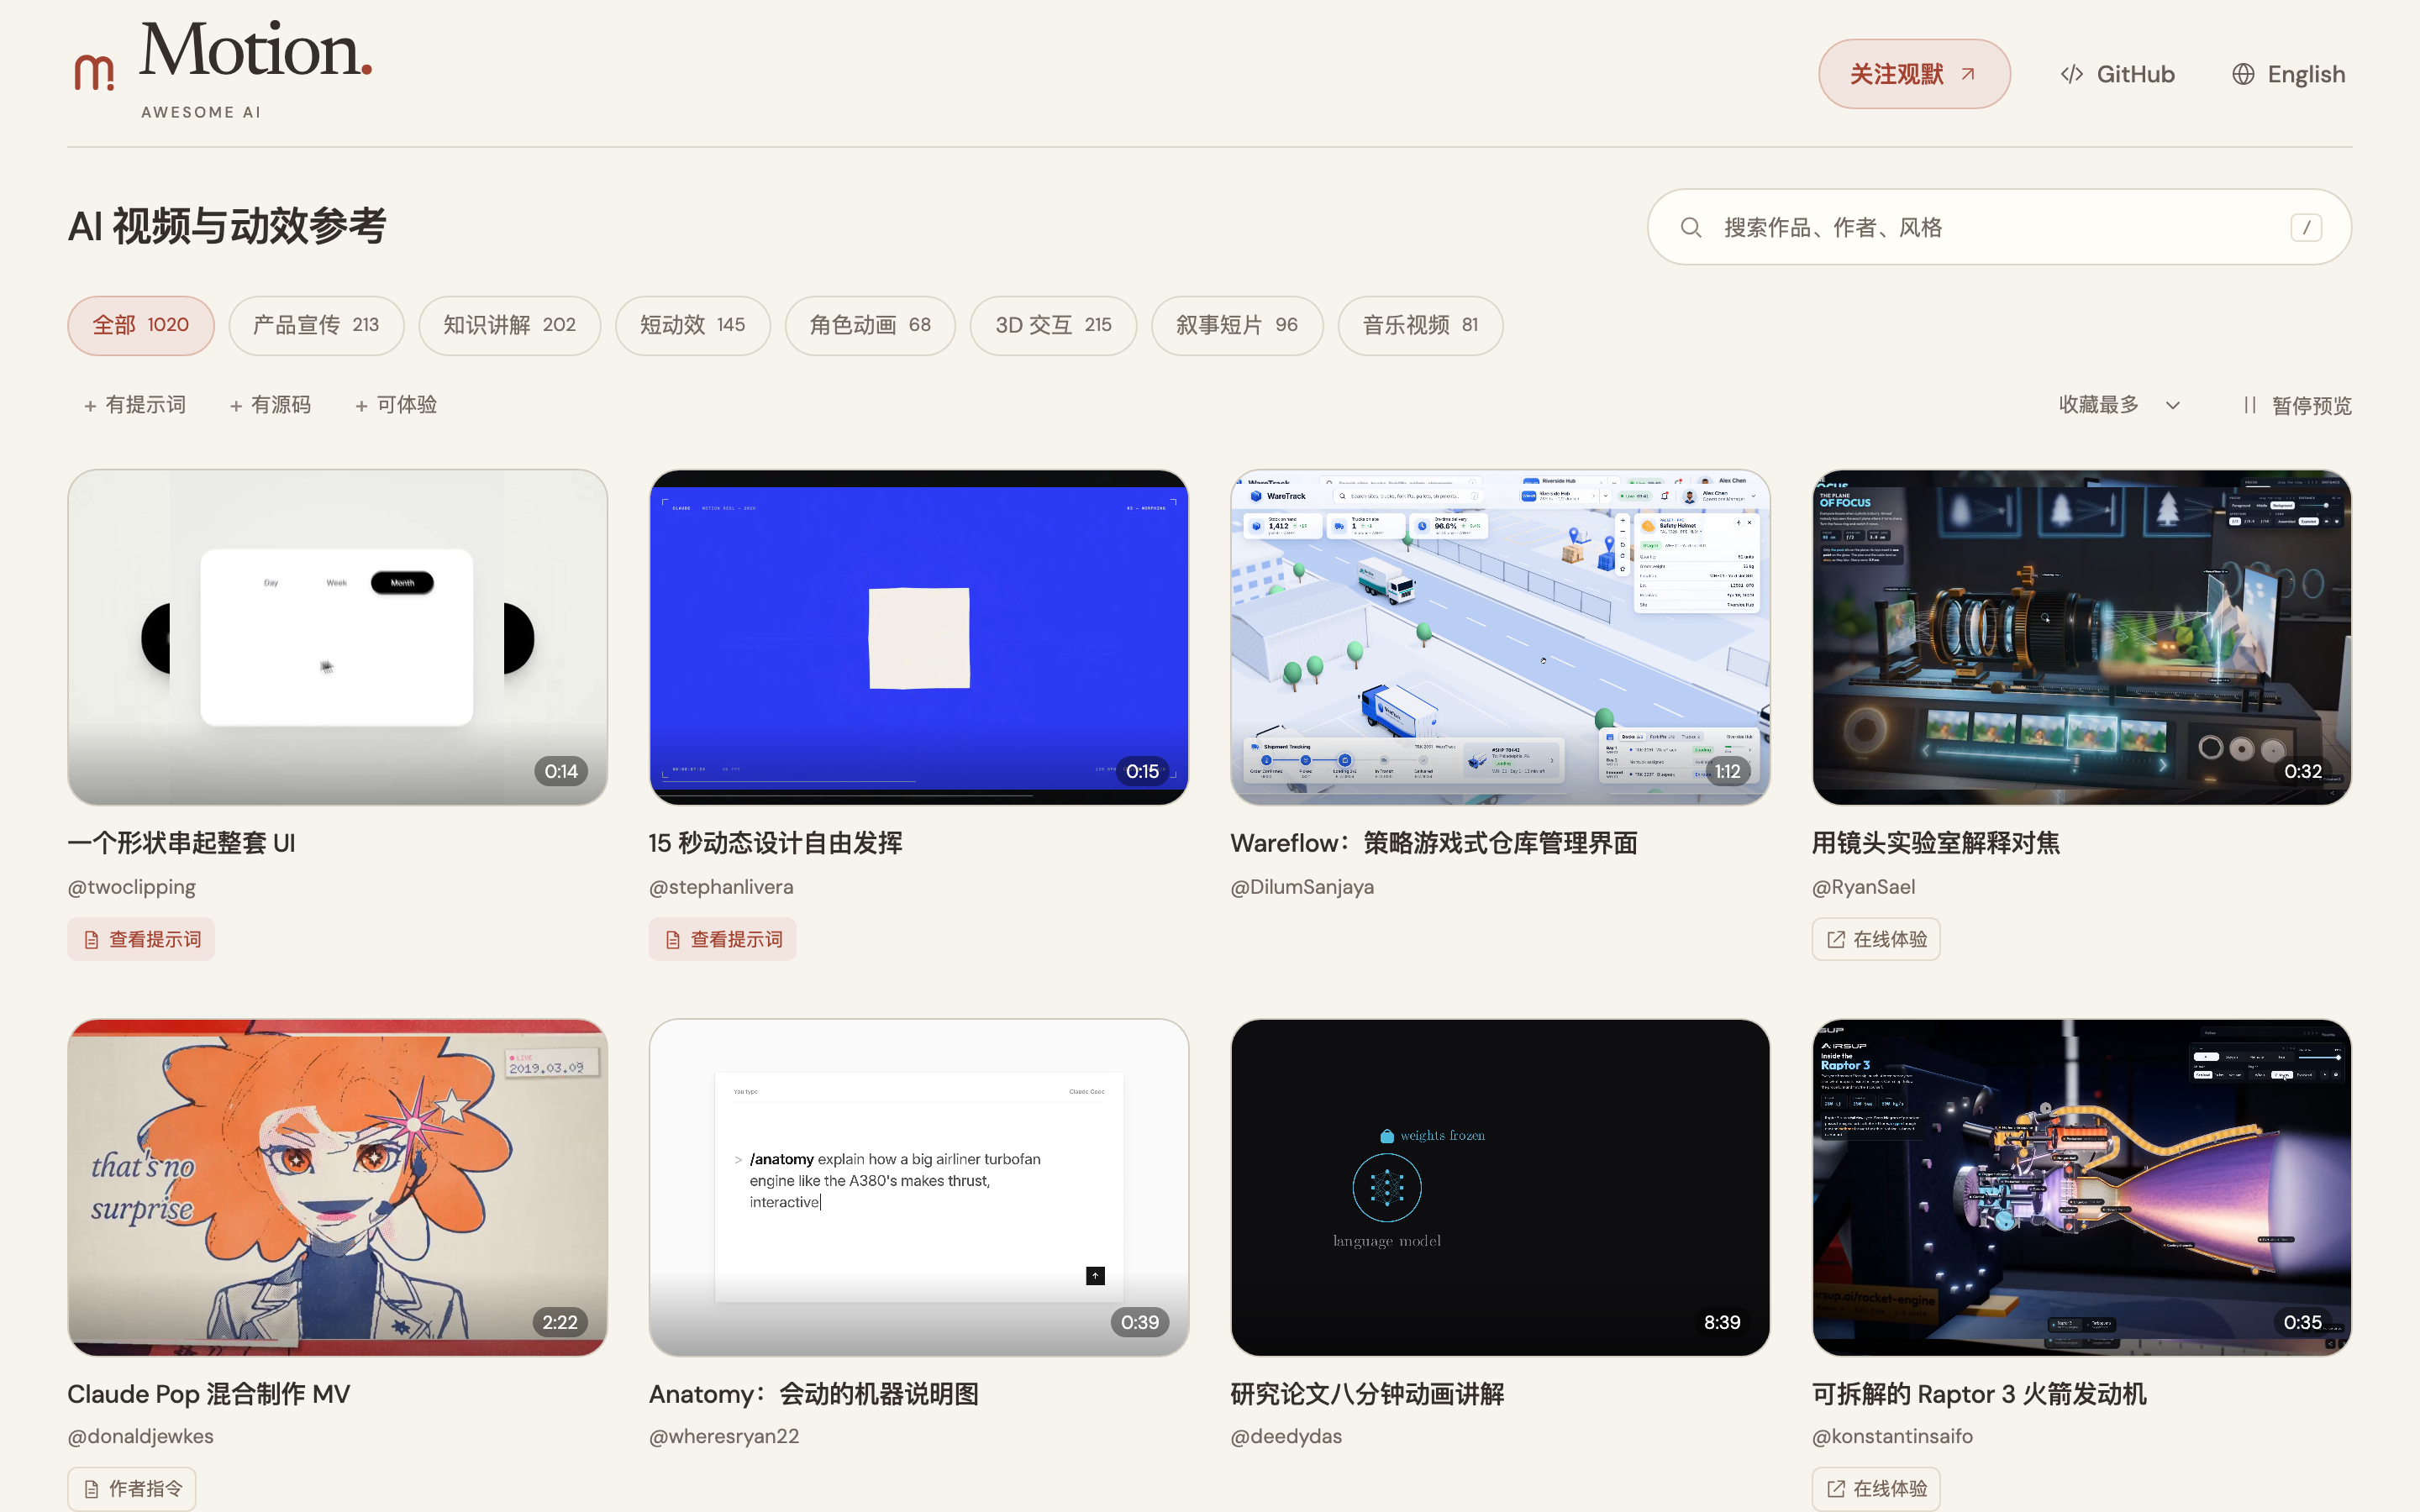
找到以后,把链接贴给 AI,告诉它照着这个风格,做一条讲某某概念的视频就行。这也是我比较推荐的办法,知道自己要什么样子,链接一贴,就可以发号施令等最终成片了。
我这里从Awesome AI Motion 里选了几条科普讲解类的原始作品贴在这里作为参考:
你给的参考也可以是一个 Skill,比如这种专门讲机械原理的 Anatomy,它把这类画法打包好了,装上以后让它讲一台机器怎么运转,就可以做出这样的效果:
画面需要的素材,也可以都交给 AI 去做。直接让它写代码做,出来的一般是图形、文字、图表这一类动效。但如果需要人物、照片这类素材,可以让它先去找,比如去 Unsplash、Pexels 这类图库找能商用的图片和视频。
如果图库里找不到想要的素材,可能就得自己生成了,这时候可以给它接上文生图、文生视频模型的能力,它会自己去调用 API、抽卡、挑选结果,整合到视频素材里。代码负责位置、结构和动效,生成模型负责人物和质感,我也看到不少两者相结合的案例:
| 代码加生图 | 代码加视频模型 | 粗模加视频模型 | |
|---|---|---|---|
| 适合做什么 | 角色、插画由生图出,代码负责排版、移动、合成 | 人物动作、氛围镜头这类可以替换的素材 | 先用 Blender 粗模定构图和机位,再让视频模型出写实质感 |
| 要留意的地方 | 图里的文字和数字要另外核 | 同一张图每次结果不同,要多抽几次 | 要专门写提示词,免得模型照抄粗模的质感 |
| 例子 | AZIZ 原帖 | Koldo 原帖 | Ori 原帖 |
做出来以后,还有一步很关键,让它自己先审一遍。AI 能看自己渲出来的画面,也能请另一个模型来挑毛病,这样它自己在做的过程中就能发现、自己改。
比如我之前测试时,只给 Claude 一句话「做一个 30 秒左右的科普动画,讲清楚地球上为什么会有四季」,Claude 做完第一版,自己想到请 Gemini 帮它审片、试听,前后改了四版才交付给我,大约一个小时,当我看到最终的成片的时候,已经没有什么问题了。 所以给它下任务时,可以顺手加一句「做完自己审一遍,有问题改完再给我」。
这条视频,Claude 前后调了 83 次模型,一共处理了约 1,600 万 token(绝大部分是重复读取上下文,见文末总表),按 API 标价折算约 12 美元,按订阅估算约 0.3 美元。
按第二种办法(找参考片,让 AI 拆了再仿),我也实测了一次。参考的就是前面提到的「比特新语」,找来他最近几条播放量很高的视频,交给 Claude 先做拆解。
拆解报告很长,下面是其中「怎么照着做」的要点。做片子时,我把整份报告连同 4 条参考原片,附上抽好的帧和解析好的屏幕文字一起交给了 Claude,让它边看原片边做:
| 拆出来的 | 他是怎么做的 |
|---|---|
| 开头 | 头两秒就是一个具体的人、一个反常的瞬间,比如「领奖台上,第二名笑不出来」 |
| 标题 | 第 18 秒左右出标题卡,发光的衬线大字,名字有画面感,比如《银牌的眼泪》《剃刀》 |
| 讲法 | 一条片子只讲一个概念,用两三个递进的数字推着走,比如 80%、51%、33% |
| 结尾 | 回到开头那个人,收一句安慰或劝告,最后一张卡列出论文出处 |
| 节奏 | 每 2 到 3 秒一句字幕,每秒约 5 个字;画面每两三秒都有新变化,但都在推同一件事 |
| 声音 | 没有旁白,讲解全靠屏幕文字,配一首氛围音乐 |
| 画面 | 深色底,发光的点和线,衬线中文大字,旁边配英文小字 |
然后我再指定一个主题,这里我选择了投资中「看得越勤,亏得越多」,让 AI 学习参考视频后再应用到新视频中来解释这个概念,它给我生成的片名叫《刷新》。
这个选题涉及行为金融里的「短视损失厌恶」(myopic loss aversion),是 Benartzi 和 Thaler 在 1995 年提出的:人怕亏,又看得太勤,短期的涨跌里亏损就显得格外多,于是可能少配股票。1997 年的实验里,结果看得越勤的那组,承担的风险越少,最后赚得也越少。这说明频繁查看可能影响风险选择和收益,不能据此说看得越勤就一定亏得越多。
成片如下:
| 无配音版 | 配音版 |
|---|---|
两版用的是同一套画面和配乐,配音版给每句屏幕文字配了旁白,用的是我上一条视频的音色;为了让出旁白,配乐压低了一些,字幕时间和结尾画面也跟着微调,最终效果我感觉还行,能给 70-80 分吧。
从开头到配音版,AI 前后做了大约三个多小时,其中差不多一个小时花在等审片超时和返工上。Claude 一共处理了约 5,800 万 token,按 API 标价折算约 51 美元;配音和审片另外约 0.2 美元。
整理了我的三条片子花了多少
| 时长 | AI 用时 | Claude 处理的 token | 其中它写出来的 | 按 API 标价折算 | 按订阅估算 | |
|---|---|---|---|---|---|---|
| 「为什么有四季」 | 30 秒 | 约 1 小时 | 约 1,600 万 | 约 16 万 | 约 12 美元 | 约 0.3 美元 |
| 「刷新」 | 两分半 | 约 3 小时 40 分 | 约 5,800 万 | 约 29 万 | 约 51 美元 | 约 1.3 美元 |
| 「攒多少钱才能不上班」 | 46 分钟 | 约 90 小时 | 约 38.9 亿 | 约 1,300 万 | 约 2,000 美元 | 约 50 美元 |
「按订阅估算」:长片用掉 Max 20x(每月 200 美元)约一周的额度,约 50 美元,对应标价约 2,000 美元,另外两条按这个四十分之一的比例折算。
所以现在短片制作变得很简单了,这种时长几分钟的片子,拆解、模仿、试错在一个对话里就能完成,不需要什么复杂工具。把想讲的内容和想要的样子告诉 AI,再改上几轮,就能做出一条不错的动画。
二、长片,我的做法
我用了什么工具
短视频可以直接 Chat 生成,但是如果想做几十分钟的长视频,有一两百句旁白、上千格分镜,不可能都塞在一个对话里反反复复地改。
比如一个 20 分钟的视频,它的文字稿可能就有 6000 字,平时生成这么长的文章我都要自己修改很多轮,这种情况下,还想指望它再把视频给做完做好,基本不可能。拿我上一条 46 分钟的视频来说:四章正文的旁白有 162 句,分镜拆成 1,134 格,平均 12 个字一格,几格共用一张关键静帧,一共五百多张;每两张关键静帧之间是一段动画,渲染时切成 574 段,还配了 15 首曲子。因此对于长视频,或者是需要对内容有更多的把控,就需要能一段一段地改稿子,要能一段一段地审画面,改了什么、谁在改、改完没有,都得有地方记着。所以做长片,就需要一个合适的工作流。
我所有任务都是在 Obsidian 这个软件里完成。最早我用 Typora 写博客,要用 Agent 就得另开一个终端,两个窗口来回切,而且两边不互通,我需要精确描述“有一段提到了 2.7%,3% 这两个数字,需要补一下参考链接”,当需要改的内容多了之后,这个流程就很麻烦。
后来调研了一番,发现 Obsidian 有个插件叫 Claudian,能在笔记旁边直接用本地的 Claude Code 和 Codex,选中一段文字就能跟它聊、让它改,另外复用本地 Agent 的好处是它能直接读写文件、跑命令、派后台任务、使用我给它搭好的工具。因此后来在做视频时我也接着在 Obsidian 里做,还是在右边给 Claude 派活,让它调研、拆参考片、做视频。
我可以在中间直接改稿子,也能选中一段写评论,攒一批让 AI 一次处理完;涉及到复杂画面和动效,直接放进 Obsidian 自带的白板 画布里审,后面讲到写稿和分镜时再介绍。
Obsidian 的插件市场很丰富,缺什么能力可以让 AI 去找现成的。实在找不到现成的,就让 Claude 自己写一个,这些都不用自己写代码,跟它说清楚想要什么样就行。
简单整理下我最近写作、做视频时常用的一些插件:
| 插件 | 能力 | 来源 |
|---|---|---|
| Claudian | 选中 Obsidian 文档的一段内容,在右边直接 AI 对话 | 社区插件 |
| Review Comments | 在文档里直接评论,最后让 AI 统一处理 | 社区插件 |
| Embed HTML | 在 markdown 里直接看 HTML 图表 | 社区插件 |
| Canvas 画布 | 审阅视频画面 | Obsidian 自带 |
| Bases | 记录各种 TODO 项,进行项目管理 | Obsidian 自带 |
| 锁定插件,加一个检查脚本 | 定稿后,标记改好的段落避免被 AI 再次改动 | AI 自己写 |
模型我主要用国外的几家,核心是 Claude。各家有各家的长处,我现在是混着用的:
当然实际上做短片不需要开这么多的订阅,最基础的都够了,但长视频对 token 消耗就非常大了,因此我最近也尝试开始让几个模型一块干活,减少对 Opus 的消耗:
- 代码、动效、派活和项目管理交给 Claude
- ChatGPT 那边给的重置额度比较多,所以审稿、挑错和调研我会派给 Codex
- Gemini 的文字功底不错,有些初稿我会先让它写,再看效果;因为 Gemini 支持音频,所以配音和试听也交给它
这里面最难的其实是 Claude,很多人在国内是订阅不了的,A\ 封号确实狠。。。但实际上我觉得也不用太担心模型的问题,现在各家模型发展的也很快,可能再过一段时间,国内大模型也能达到这样的效果了。现在如果只能用国内模型的话,可能就需要花点时间在效果打磨上。
| 模型 | 主要分工 |
|---|---|
| Claude Opus 5.5(Claude Code) | 做动画、写代码最强,基本全能,主力 |
| GPT(Codex 里的 GPT 6 Astra) | 审稿、挑错、调研 |
| Gemini | 有专门的 TTS 做配音;能直接听音频,适合试听配音和配乐;文字功底不错 |
而我在其中的角色,更像导演加主编:这条片子讲什么、主张是什么,稿子怎么写、哪段要删,画面用什么风格,每个画面讲没讲对,声音听着顺不顺,最后发不发、怎么发,都由我来拍板。
有了这些工具后,下面看一部长视频是怎么制作的。
视频制作的基本流程
我在做上一条视频之前,对影视制作没有任何积累。因此我让 AI 去调研了几家做讲解动画的工作室和头部 UP 主团队,看他们是怎么做出一条片子的:
| 环节 | Kurzgesagt(几十人的动画工作室) | 3Blue1Brown(Grant 主导的小团队) | 影视飓风(头部 UP 主团队) |
|---|---|---|---|
| 选题 | 研究员先写主题文档,决定做不做 | 先找一个能撑起整条叙事的核心画面 | 编导拿标题加封面过选题会 |
| 写稿 | 十几稿,专家审两轮;写完才开始画 | 有讲稿,做动画时会回头改;写稿前先给朋友和学生试讲 | 编导调研、撰稿、列分镜 |
| 画面 | 插画 2 至 3 人画 8 至 12 周,动画 2 至 3 人做 8 至 10 周 | 自己写 Manim 代码,交互预览,一镜一镜渲 | 策划阶段先用 AI 生成参考视频,再实拍 |
| 配音 | 插画画完才录旁白 | 动画排好时间线后,自己录 | 先用自训的 AI 声音搭粗剪、给甲方审,稿子定了再真人录 |
| 剪辑和配乐 | 查不到细节 | 自己剪,约一天;配乐几乎都由作曲 Vincent Rubinetti 写 | 后期约留 15 天 |
| 发布前后 | 简介附研究和来源清单,出错公开认错 | 赞助者提前看,可能改进公开版 | 发布后看点入率、平均观看时长、平均播放百分比 |
| 人和时间 | 一集至少 1,200 个工时 | 一条常要一个月或更久;官网列出他加 7 位成员 | 内容团队八十多人,同时 24 条在做;每位编导约 45 天出一期 |
看起来非常复杂对吧,以往插画、动画、录音、剪辑、配乐这些角色在传统团队里各有专人负责,但现在制作这种用代码出画面的知识类视频,这些角色都将交由 Agent 承担,人只要把控几个关键节点就够了:
- 立项:确认讲什么、给谁看
- 剧本冻结:调研、写稿,打磨出文字稿
- 风格冻结:定下来风格和关键元素
- 关键静帧:按句出静帧,看每句画面讲没讲对
- 动画初版:看动作、节奏和旁白对不对得上
- 成片放行:解决所有问题后,观看最终成片
六个审阅节点
配音、配乐和发布不单独设节点:配音处在风格冻结和关键静帧之间;配乐方向随风格冻结一起定,排曲和音效在动画之后、成片放行之前;发布放在最后。后面各节就照着这张图,按照各个阶段往下讲。
立项:选题
长片的第一步是选题。选什么题,每个人看法都不一样。可以是自己的经历和问题,可以是最近读到的东西、刚做成的一件事,也可以是看到别人做火了某个题、评论区里大家反复在问,就赶紧跟上。这里我也列了一些找选题的方法:
| 来源 | 怎么做 |
|---|---|
| 自己的经历和问题 | 翻最近的困惑和踩坑,改写成「为什么会这样、怎么解决」 |
| 刚做成的事、失败复盘 | 记下过程和前后差异,找出做之前不知道、做之后才知道的那一点 |
| 阅读和学习笔记 | 从书、课、论文里摘一个反常识的点,问它解释了什么现实问题 |
| 对标同行和爆款 | 拆同类作品回答了什么、凭什么吸引人、哪里没讲清,找自己的补充角度 |
| 评论区和弹幕 | 收集「没懂」「为什么」「能不能讲讲」,保留原句 |
| 追热点 | 从新闻里挑一个大众不懂的机制,用自己的专业讲清楚 |
| 问 AI | 告诉 AI 你懂什么、想讲给谁听,让它列出这类观众最常问、但现有内容没讲清的问题,你再挑 |
我上一个视频选「财务自由」这个话题,原因很简单:这个主题我关注得比较早,做互联网、做理财的人大多或多或少接触过财务自由和 FIRE 这些概念,我之前也有算过「多少钱才算财务自由」这个事情,所以选这个做主题也就顺理成章。
讲什么、给谁看,能用一两句话说清楚,立项这一关就过了。
剧本冻结:从调研到文字稿
稿件很重要,它把控着整个视频的节奏。稿子的深度其实就决定了这个内容能做到什么程度,别人看到之后愿不愿意往下听。再精美的画面,如果内容是空洞无味的,也很少有人愿意看完。
在我们把题目定下来后,接下来就是调研,拿更多的材料和数据,再经过梳理,把它变成一篇具备逻辑,内容详实的稿子。
写稿这一步我也是在 Obsidian 里去做,我先把能想到的方面都口述出来,跟 AI 一个一个讨论;讨论完,哪里觉得还要补,就让它去找,数据类的尤其多,比如各种历史回溯数据、参数调研。语音输入我现在直接用的豆包输入法,在中英混输的场景下识别率不错。实际上其他的输入法,比如微信输入法的语音识别能力也可以。毕竟现在模型非常强,即使语音输入转写出一些错字,AI 也完全能理解原意。所以我全程基本都是语音输入,会比打字要节省非常多时间。
另外一点是我平时有收集文章的习惯,读过的、觉得写得好的都进了 Readwise 和本地知识库,这样 AI 也能通过工具直接查到;我之前研究 FIRE 时看过的那些博客和视频,也都让它找出来当参考。连小红书上的帖子,我也给了它命令行工具让它自己去读,所以调研阶段 AI 能够从多个平台进行检索和信息收集,节省了很多时间。
上一条视频的底稿,是我先写好的三篇博客。三篇博客背后的调研量:
| 项目 | 数量 |
|---|---|
| 小红书候选帖子 | 296 篇,精读 97 篇 |
| 调研文档 | 十多份 |
| 历史数据回测 | Damodaran 1928 至 2024 年的年度数据 |
| 写完三篇 | 16 天 |
| 参考资料 | 共 58 条,包括视频、博客和论文 |
材料齐了,接下来就是打磨出一份大纲,再照着大纲一段段填内容、修正,直到成为一篇完整的稿子。写的时候我会遵循一条原则:读者读完上一段,最自然会追问什么,下一段就回答它,这样才环环相扣,读者愿意往下读。
调研加写稿是整个过程里最花时间的一段,我上一个视频因为内容非常多,花了我大概五六十个小时,比后面做视频的时间多出一倍还多:两三万字的博客加上各种配图,我实际上都是一一把关,同时鞭挞 AI 改到我满意的效果。
博客写好,为了做视频还要改成旁白稿,博客里有些东西在视频里没法直接展示,比如大表格、长公式、一串参考链接,这一步就是和 AI 一起取舍:不适合的精简掉,或者想办法换成画面来讲。我原先三篇博客约 2.6 万字,照着念要 85 分钟以上,取舍完,成片是 46 分钟。
在写稿审稿的过程中,我最常用的是两个插件:评论和锁定。评论插件可以在我 Obsidian 里精准划线评论,全篇 review 完之后再在右边说一句「处理下评论」,AI 一条条改完,在每条下面回复;改好的段落会标记锁定,这样 AI 就会知道这些段落不能再改了。
这样的评论要反反复复进行很多轮,直到把稿子打磨成自己想要的文字稿和旁白稿。到这一步,稿子就冻结了,之后只做微调,因为配音有多长、画面在什么时间点出动效,都是照着稿子排的,稿子一动,后面全要跟着动。
文字稿打磨完成了之后,下一步就是定这条视频的风格。
风格冻结:定下这条片子长什么样
风格冻结这一节要定三样:
- 整体长什么样(试镜)
- 画面里反复出现的东西长什么样(元素表)
- 配什么样的音乐(配乐方向)
我参考的是两部片子:画面学有知有行的《投资是怎样赚钱的?》,讲法学达利欧的《经济机器是怎样运行的》。
| 有知有行《投资是怎样赚钱的?》 | 达利欧《经济机器是怎样运行的》 |
|---|---|
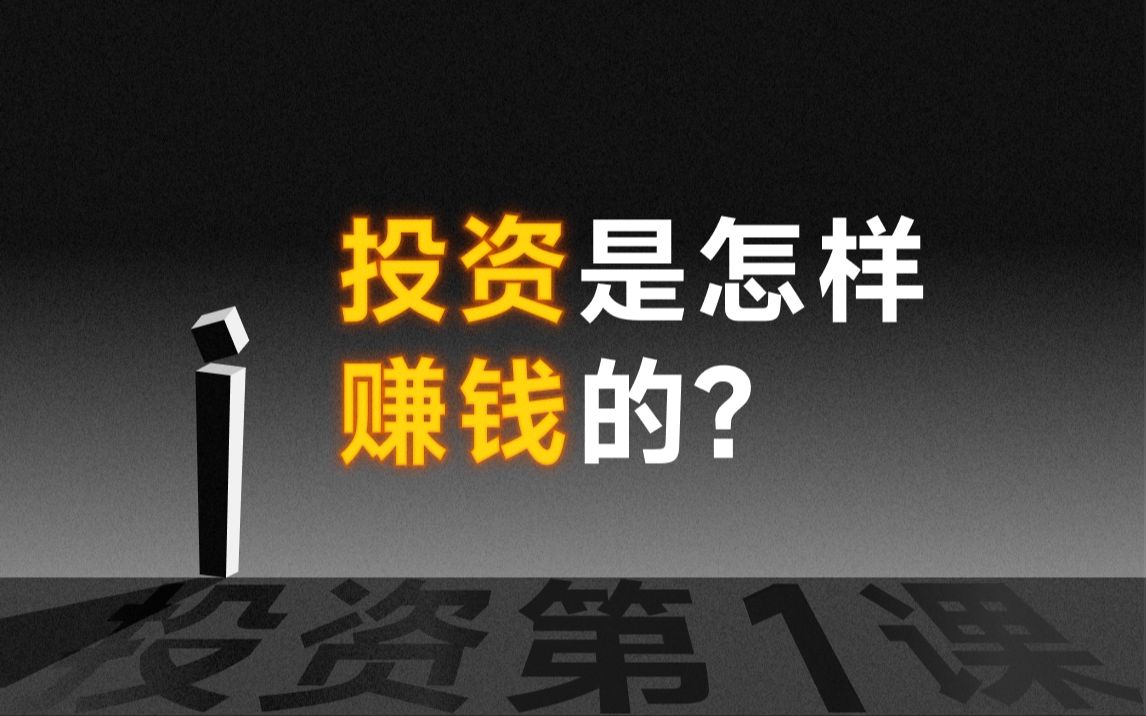 | 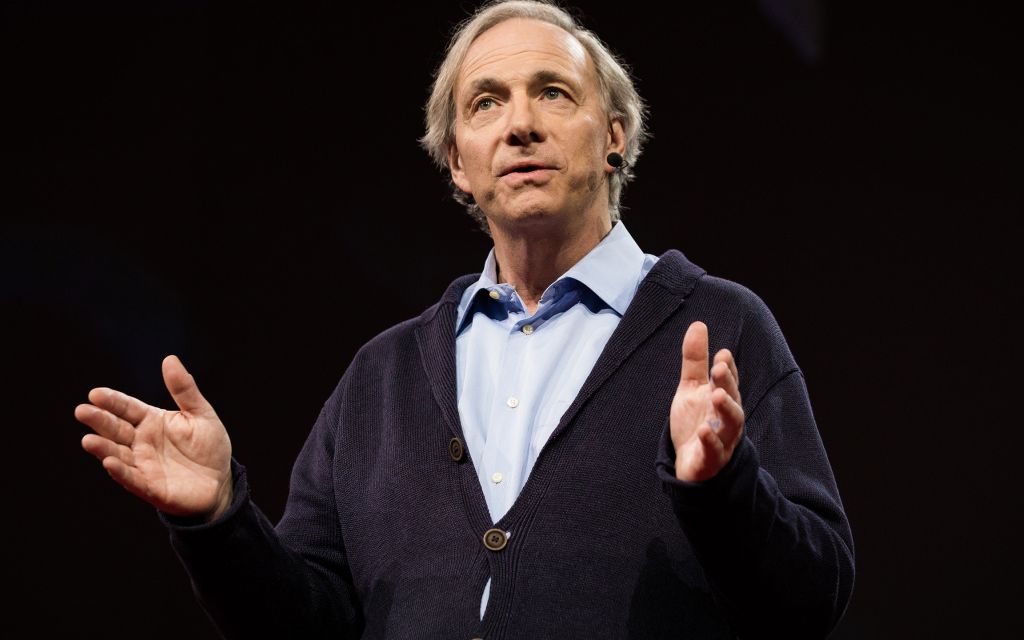 |
拆参考片的方法前面讲过。拆完以后,让 AI 对照我们这条片子的内容,提出风格规范,列出要用到哪些元素。
但规范写在纸上看不出好坏,所以要试镜:先把开头一分钟做出来,各种元素都得画出来,看看效果。前面的风格定了,后面大量的动效制作都会跟着这个风格和元素走;元素不合适就在这个阶段改好,因为等全片做完再改,每个地方都要重来了。
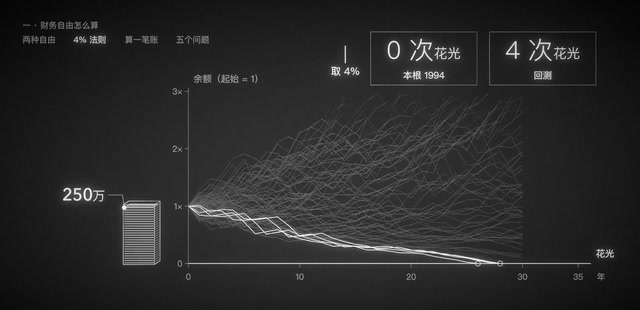
上一条视频的试镜前后走了三轮,每一轮回答一个问题:数据图怎么画,用什么工具做,质感做到什么程度。
第一轮,数据图怎么画。「4% 法则」那组回测数据一开始试了三种画法,三种都被我否决,最后退回了一张平面折线图:
| 彗星地形 | 排线 | 折线彗星 | 最后用的:平面折线 |
|---|---|---|---|
 |
图怎么画定了,下一个问题是用什么工具把它做出来。
第二轮,用什么工具。我一开始只说要 3D,AI 自己挑了 Three.js,做了两天原型,质感一直差一截。后来让 AI 换 Blender 跑了两小段,和 Three.js 版一比,当晚就定了改用 Blender,前两天的原型基本推倒重来。所以试镜最好头一天就拿最难的镜头试。
| Blender 第一次测试:需要 vs 拥有 | Blender 第一次测试:水池见底 |
|---|---|
工具换成 Blender 以后,剩下的是质感:同一个镜头,要改到什么程度才算够。
第三轮,质感。同一个镜头从 Three.js 版、Blender 预览,一路改到终版:
| Three.js · 9/29 | Blender 预览 · 10/1 | 终版 · 10/6 |
|---|---|---|
三轮试镜定下了工具和大方向,但开场这一分钟离成品还差得远,接下来是一版版往下磨。下面是开场第 2 版和第 4 版的同一批镜头(K07 这些是镜头编号):
| 镜头编号 | v2 | v4 | 这一镜改了什么 |
|---|---|---|---|
| K07 | 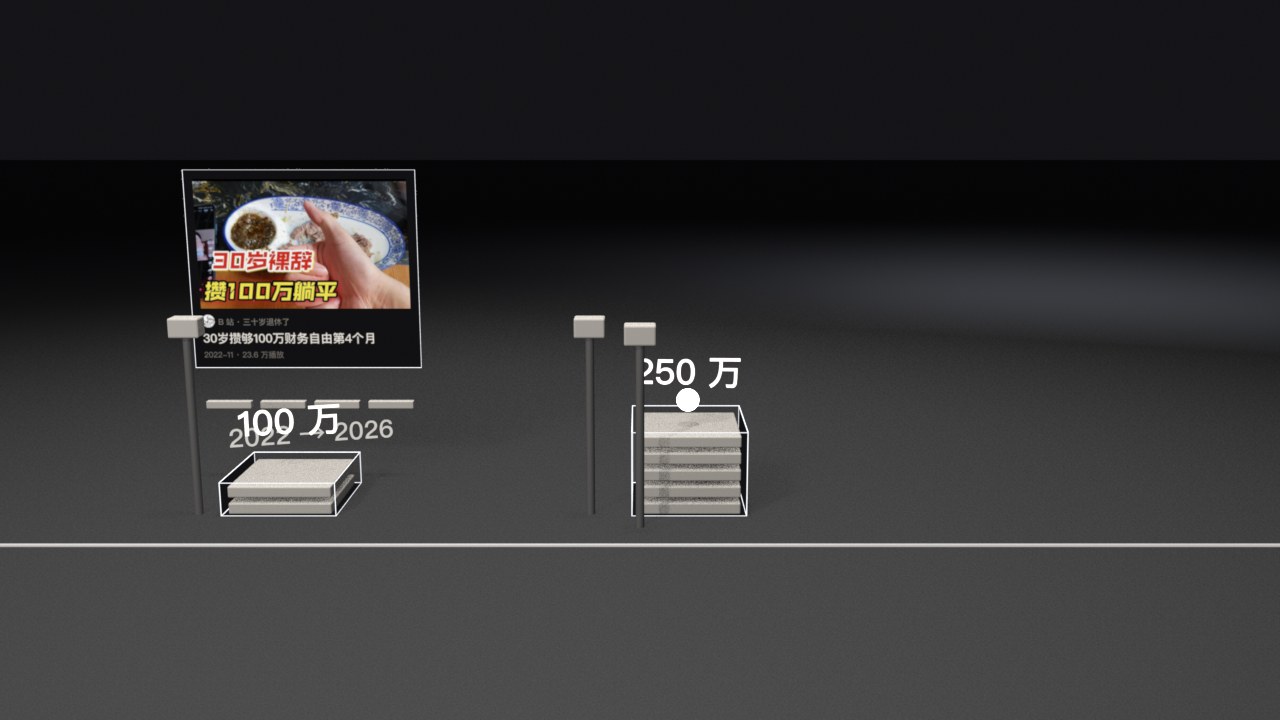 | 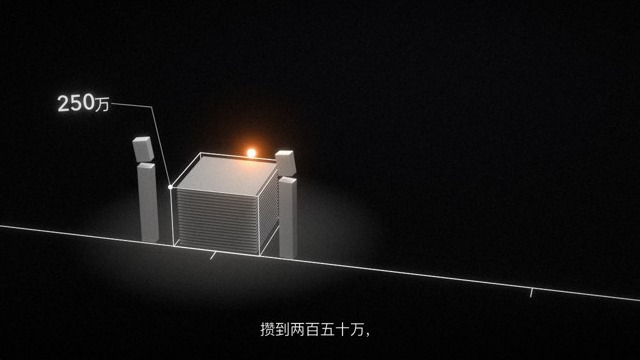 | 广角换成长焦俯视,灰地灰天改成黑底加光池;钱从厚板变成薄片,钉子人变成方块人,标签改成大数字、小单位,配引线 |
| K15 | 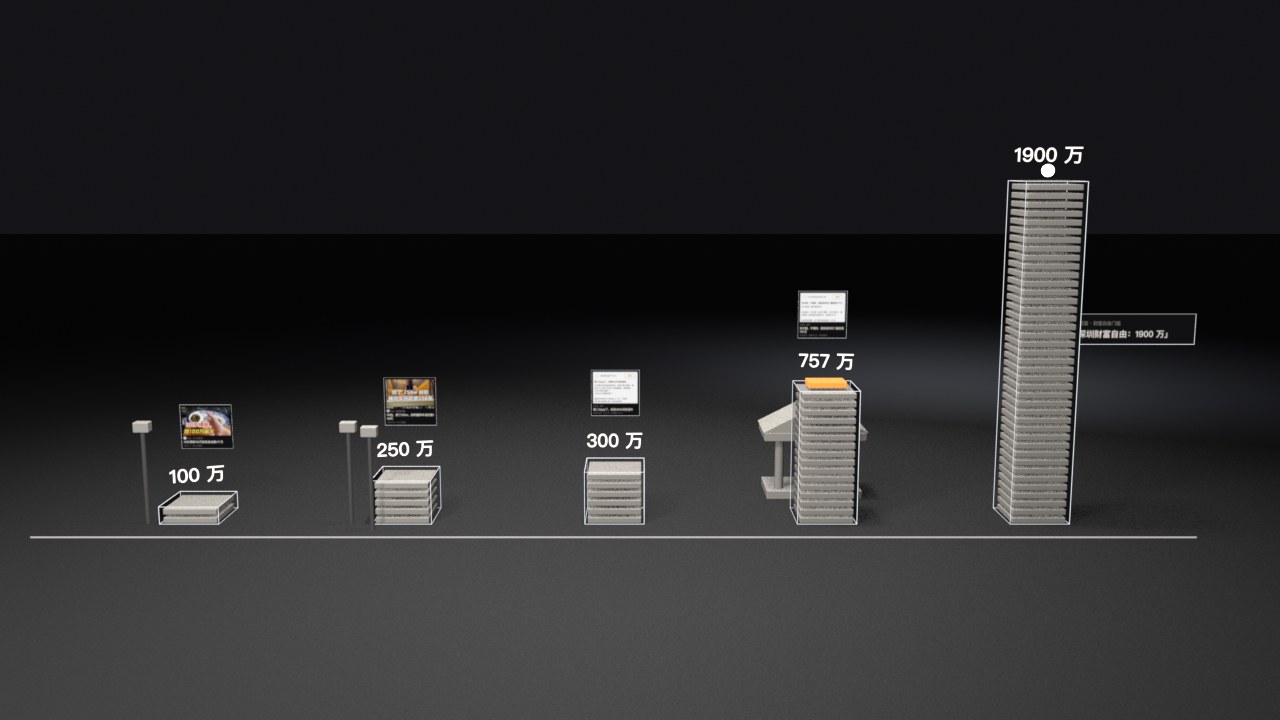 | 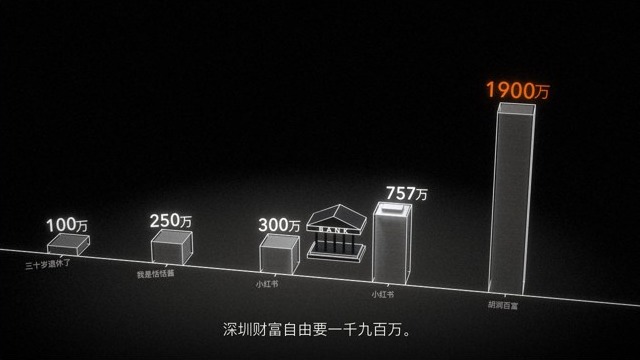 | 柱底统一、柱高按金额比例;白色神庙银行改成深色体块加细柱廊;看不清的小截图换成一行来源小字;橙色只留给答案 1900 万 |
| K26 | 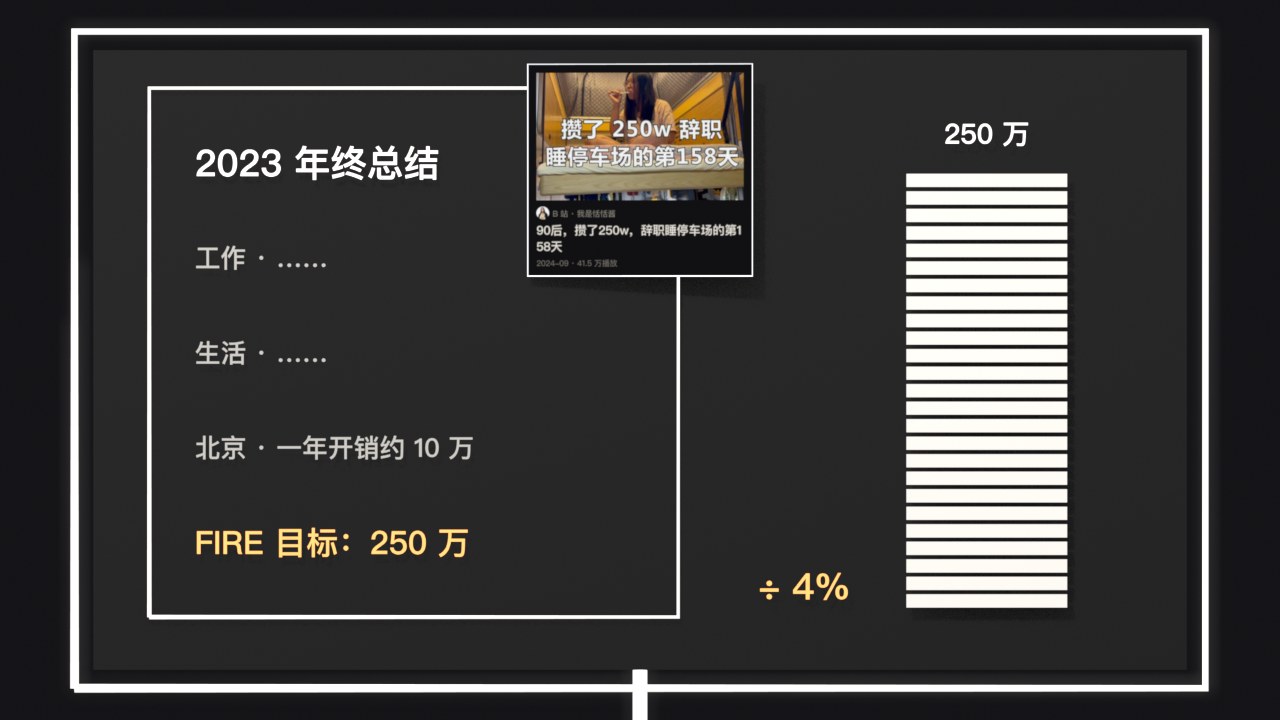 | 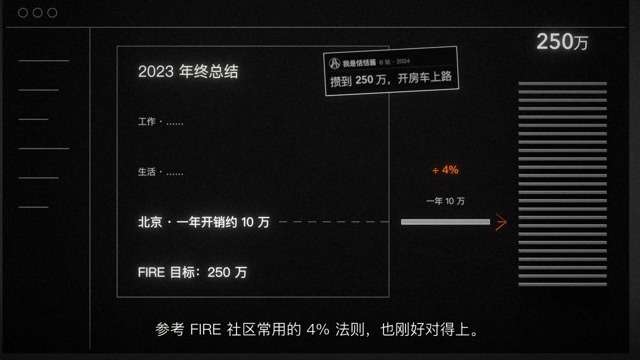 | 截图换成统一的帖子卡片;「÷ 4%」从文档边上移到「一年 10 万」和钱柱之间,用虚线和箭头连起来;画面压暗 |
| K36 | 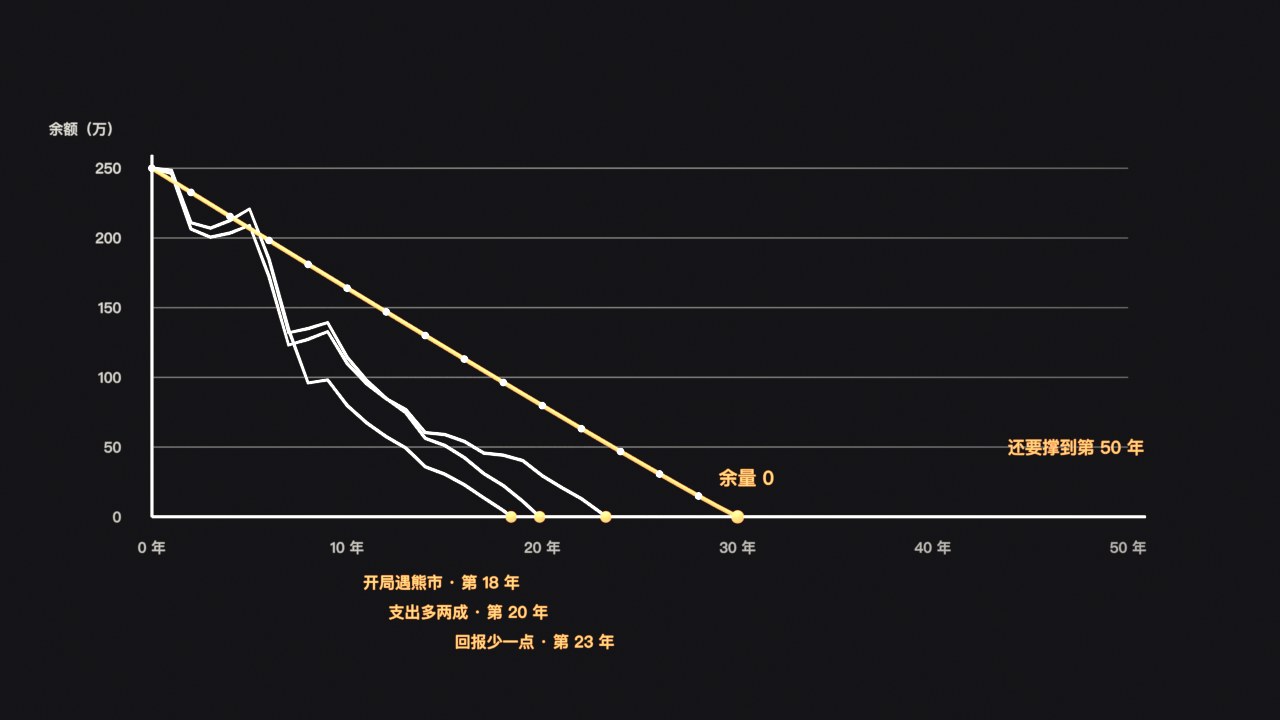 | 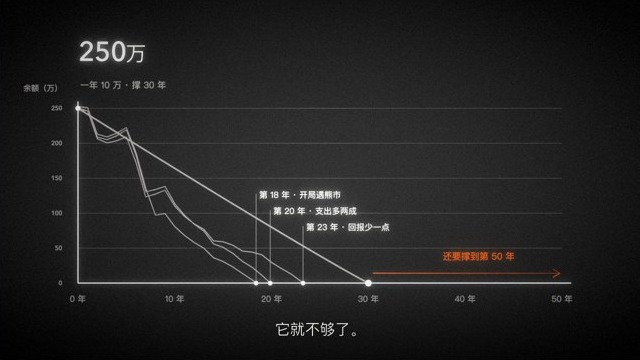 | 橙色从八处以上收到只剩「还要撑到第 50 年」;三个触底年份从挤在角落的一团,改成各自贴在触底点旁边,用竖线落下 |
能够明显看到 V4 要比 V2 好很多的。但其实在这期间我没有花很多时间,我只是要求 AI :「这一版做得不够精致,和有知有行差在哪,按照自己的理解,打磨好我们的风格,不要吝啬时间和 token」。
接下来的事情全是 AI 自己干的:主会话把成片和有知有行并排,逐项找差距,再派一个独立的审片代理专门挑毛病,一轮轮改,改了什么见上面的表。我提的只有两类:哪里该用 2D,人物朝向不对。
所以这个阶段,人该做的是两件事:说清楚和参考差在哪,然后放手让 AI 对照着改,改完再看。
磨完以后,片子里反复出现的东西长什么样也就定了。把它们一样样列出来,做成一张元素表,后面每一章都照着用:
上一条视频的元素表
 人物①:胶囊人(否决) | 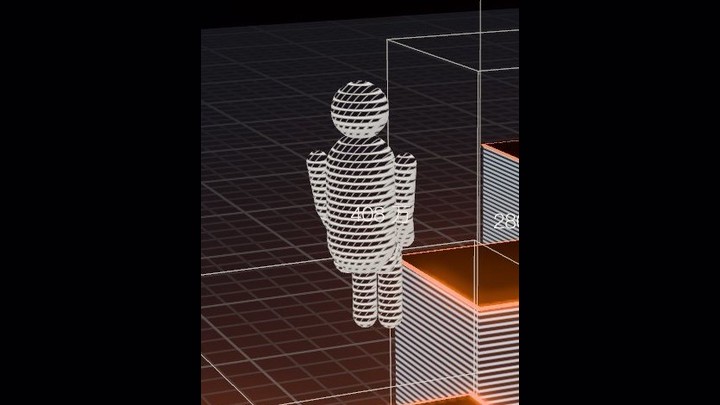 人物②:关节人(否决) | 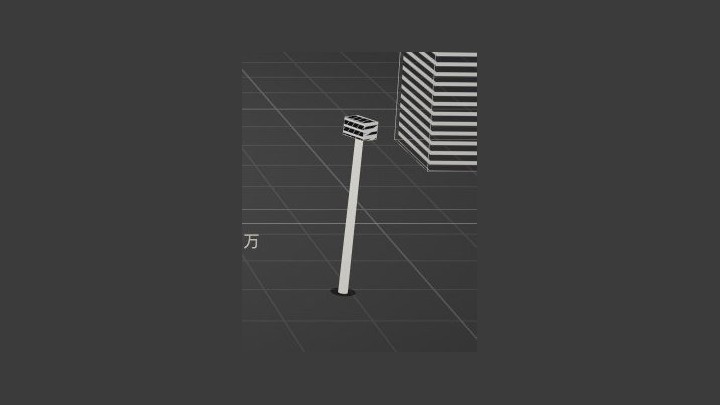 人物③:钉子人(否决) | 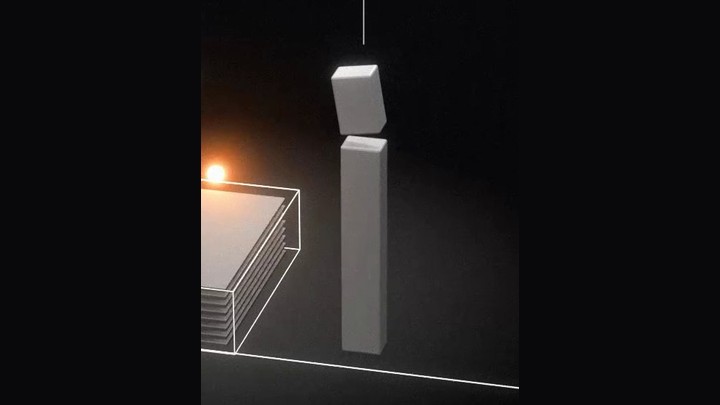 人物④:方块人,定稿 |
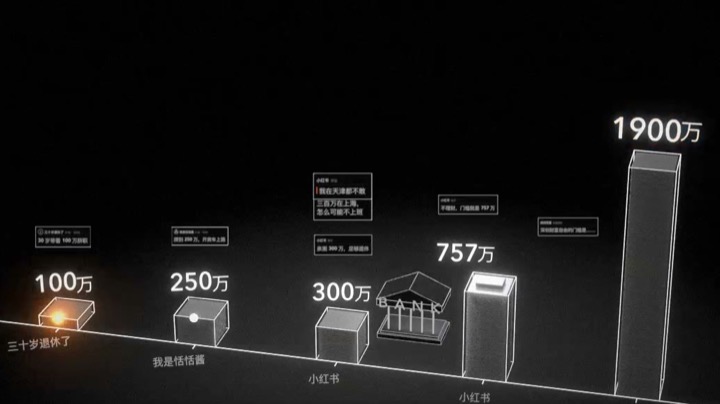 钱:薄片,100 万 8 张 | 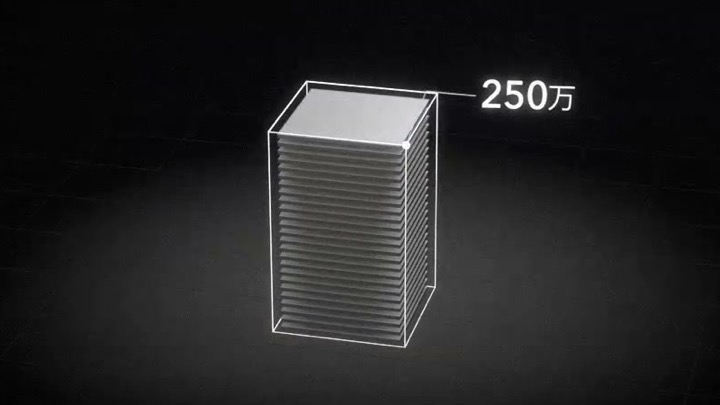 玻璃盒:钱高即水位 | 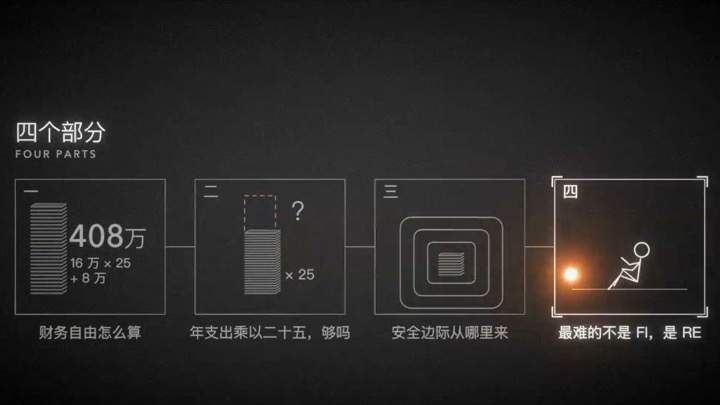 强调色:一格只一处橙 | 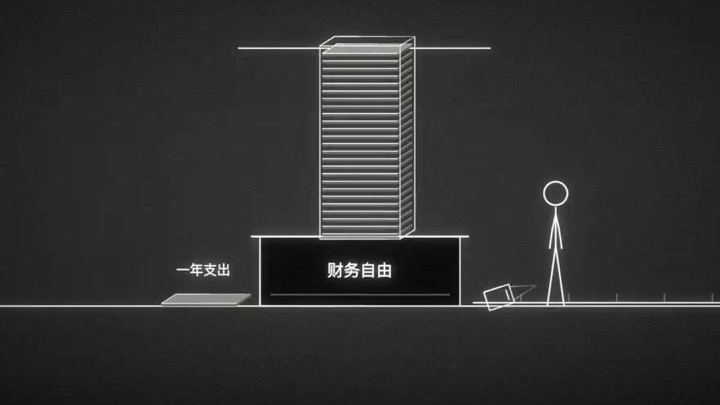 3D 和 2D:钱 3D,人和字 2D |
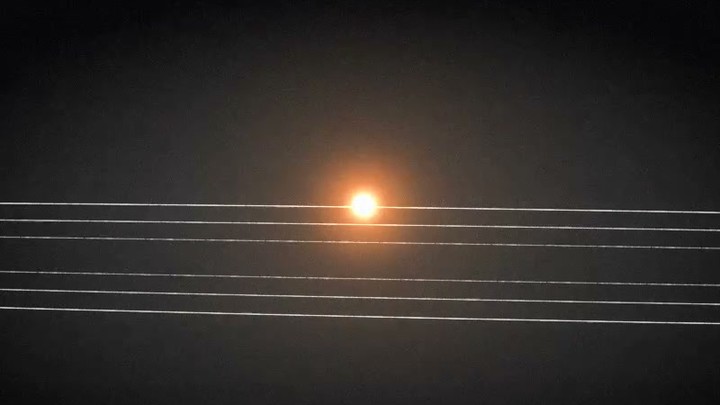 光点:白芯橙晕 | 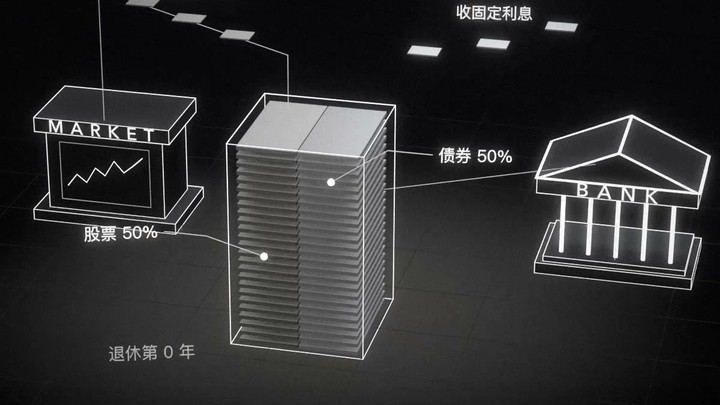 银行和市场:退在钱后面 |  帖子卡片:统一黑底细框 |  目录条:当前一站提亮 |
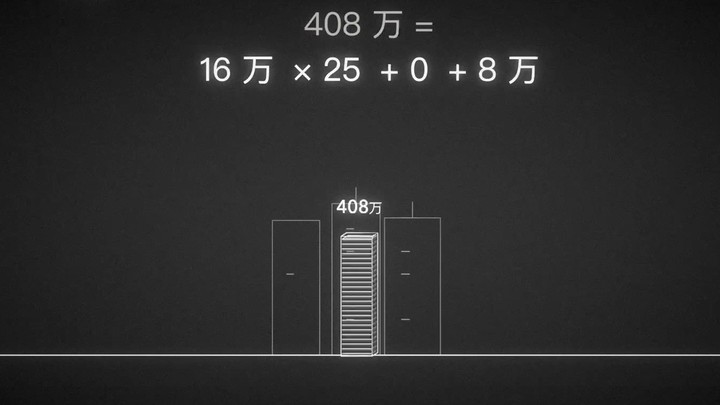 公式:逐项代入数字 | 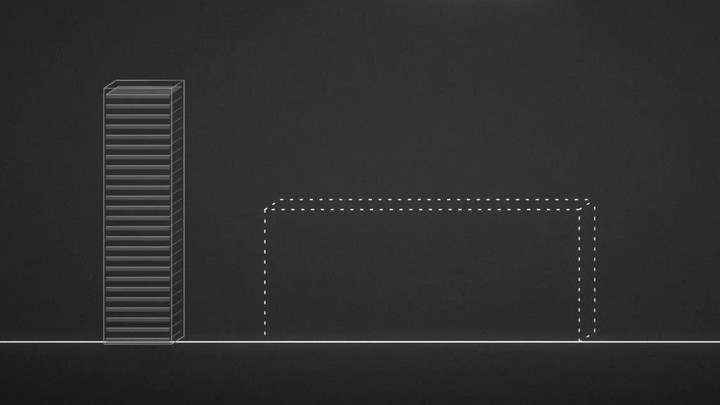 虚线盒:还没攒到的钱 | 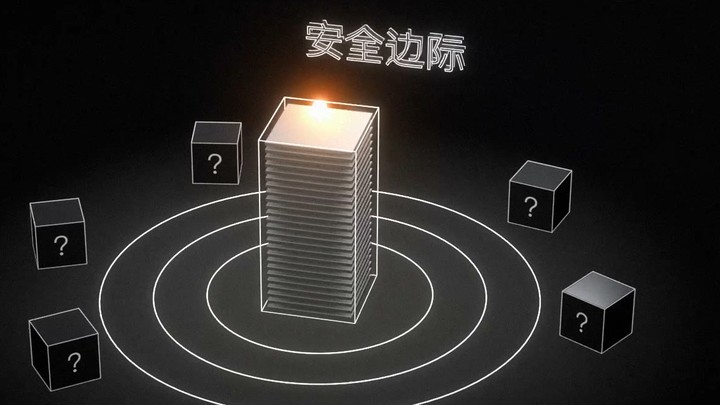 同心圆:安全边际 | 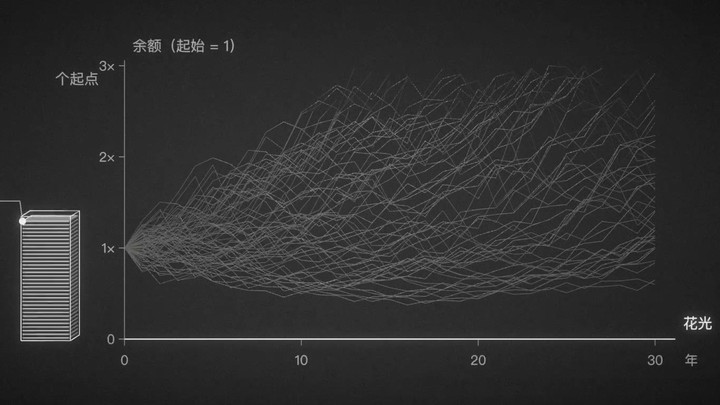 路径束:68 个历史起点 |
元素在这一步改,只是改一张图;铺完全片再改,就得一个镜头一个镜头换。
配乐方向也放在这一步,跟试镜一起定。试镜样片配上两三首候选曲子,画面和音乐的气质搭不搭,一起听一遍就知道。上一条视频的配乐就是拖到动画快做完才开始找,就太晚了,没有时间打磨。
风格冻结这一阶段,需要把开场这一段的风格、元素、配色和配乐方向都定下来,后面每一章照着做。
风格和配乐方向定了,接下来就是声音。
配音
配不配音,是这一步要先想清楚的事,它决定了后面改稿的代价。
有配音的片子,画面跟着声音走。一句话念多久,这段画面就展开多久;念到哪个词,哪个元素就在那一刻出来。句子一改,念的长短和停顿都变,这一段的动效就得重新设计、重新渲染。不配音的片子只有字幕和音乐,句子改了,换一行字幕就行,画面的节奏可以照旧。很多讲解短片干脆不配音,这样改起来也最省事。
上面是原稿的时间轴,下面是改稿后的:句子多了几个字,后面的动作整体往后推,上下对不齐的部分可能都要重渲,所以做配音的时候,最好整个文案都已经定型,不然文案、配音一变就会带来大段的修改工作。
如果确定要配音,接下来就选择是自己配还是 AI 配。我选的是 AI:它对环境要求最低,花点钱就能拿到还不错的效果;自己配的话,得有好一点的麦克风、安静的环境,还要有节奏感。
在选配音服务时,主要看三件事:
- 音色能不能固定:一条长片一两百句,要分很多次合成,每次都得是同一个声音,不然观众听得出换了人
- 授权能否商用:免费版、克隆别人的声音、开源模型的权重,常常不许商用,发之前要看清条款
- 能不能出逐字时间戳:就是每个字在第几秒念出来,画面要踩在词上,靠的就是它
| 服务/模型 | 中文 | 价格 | 逐字时间 | 商用 |
|---|---|---|---|---|
| Gemini 3.8 Flash TTS | 支持 | 音频输出约 0.0135 美元/分钟,另计文本输入;2027 年起翻倍 | 要另做对齐 | 按 API 条款 |
| CosyVoice v3.5 Flash | 中文、多方言 | 0.8 元/万字符 | 部分音色支持 | 按音色及克隆授权 |
| MiniMax speech-2.8 HD | 中文、粤语等 | 3.5 元/万字符,一个汉字算两个字符 | 可设成逐词 | 按 API 合同 |
| ElevenLabs | 支持,要先试听 | 6 美元/月起 | 字符级 | 免费版不能商用 |
| Kokoro 82M(本地) | 有普通话音色 | 无 API 费 | 要验证 | Apache-2.0 |
AI 配音我们用的是 Gemini 的 TTS。我决定做视频的时候,它刚好发布,评价也不错。我让 AI 生成了几种不同的音色,挨个试听,选了现在这个。
不过 Gemini 给不了逐字时间,所以要把配好的音频再过一遍语音识别,对出每个字念出来的时刻。不过没有逐字时间也没关系,上一条视频我只有每句的起止对齐了,但是效果也还过得去,有些动画不需要精准到字级别。
关键静帧:每一句配什么画面
声音和每句的时间有了,接下来 AI 就可以按句出关键静帧了,一句旁白一行,摆到 Obsidian 的 Canvas 画布上,每一句旁白都有一个对应评论框,我在里面给意见,AI 改完在右面贴回复卡,这种方式我用起来还是挺舒服的,比起直接在 markdown 里说哪一个画面有问题要方便太多了。
样片在前面定风格那一步已经做过,到这里,风格和元素都定了,我们审阅的是每一句配什么画面。
图里四行取自上一条视频开场的分镜画布:左边是改前的关键帧,中间是我的评论和 AI 的回复,右边是改完的样子,评论和回复都是原文。
审静帧看的是:每一格要表达的意思,和这一句稿子讲的是不是一致。意思对了,再去管它好不好看。动画是为了更好地呈现内容,要防着它喧宾夺主。
上面四处都是同一类:我在画布上提得最多的,是换个表现方式。AI 起手常常是 3D,空间感很足,可有些地方我看静帧,觉得 3D 讲不清,或者讲得太绕,就提出来换成 2D,或者把镜头推进到某个东西里去。
方向是我定的,具体怎么动,比如柱子怎么压扁成横轴、钱片怎么从屏幕里拉出来长出厚度,是 AI 补出来的。
每一格的意思都对上了,接下来就是让画面动起来。
动画初版:交给 Agent 跑,我按章审
静帧审完,剩下的基本是 Agent 自己跑,我按章审:
- 按章做动画、渲染
- 渲好的整章视频摆到画布上,每句旁白一行,配一排抽帧
- 我看完在旁边写批注
- 它改完再出下一版,每章三版左右
这是第一章动画第一版的审阅画布:每句旁白一行,右边是按时间抽的几帧,再右边是我的批注和 AI 的回复。和上一节的关键帧画布长得像,区别是这里看的是动起来以后的样子,我会在另一个屏幕上去播放视频,然后有问题的地方,我会找到对应的那一行评论。
按章审完,往往要改动效、重新渲染。要是改一处就得整章重渲,一次就是半个小时,评论只能攒很久才敢处理一批,来回也慢。所以动画引擎一开始就做了拆分:全片按关键帧切成很多小段,每两张关键帧之间算一段,段和段互不干扰:改一张关键帧,只重渲它两边那两段。上一条 40 多分钟的视频,实际被拆成了 574 段,平均每段不到 5 秒,要改哪里,就把那一段和旁边的拉出来重渲。
改哪里,重渲哪些
| 改了什么 | 要重渲哪些 |
|---|---|
| 一张关键帧 | 它两边的两段 |
| 一句旁白的长短、字幕时间 | 这句话盖住的几段,后面整体后移 |
| 一段运镜 | 运镜经过的几段 |
| 引擎或后期设置 | 全部 |
拆开以后另一个好处就是能并行渲染,两台电脑各渲一部分,渲完拼起来。上一条视频最后导出整片就是这么做的,我的 Mac mini 和 MacBook Air 一起跑了六个多小时。当时发布前一晚要修第二章的数据,两台机器分头重渲受影响的那几十段,一个小时左右就渲完了,当然如果你有一台好设备,就不用折腾并行渲染了~
画面齐了,接下来就把配乐和音效配上。
配乐和音效
配乐方向在风格冻结时就该定,这里讲的是按画面排曲、做音效。配乐和音效,我也基本交给 AI。它按画面去找曲子、排位置,音效也是它按动作的时刻自动挂上去的,我听着不对再提。
但这一阶段,我们要注意的是给它用哪些曲库,这件事牵涉版权,处理不好会有被平台下架的风险。当然,其实最简单的方法就是让 AI 自己去制作音效,大部分情况也够用了。
常用曲库平台:
| 曲库 | 怎么收费、怎么授权 | 要留意的地方 |
|---|---|---|
| 剪映、必剪等平台自带曲库 | 在自家和合作平台内可用 | 搬到别的平台要逐首看标注 |
| Free Music Archive | 免费,每首按自己的 CC 许可 | 带 NC 的不能商用,带 ND 的不能改编、也不能配进视频 |
| Pixabay Music | 免费,可商用,不用署名 | 部分曲目登记了版权识别,合法使用也可能被认领 |
| Epidemic Sound | 订阅制,能按情绪、BPM 搜 | 国内平台覆盖待确认 |
| 曲多多、光厂、VFine | 按月或按首买授权 | 个人授权不能用在企业项目上 |
大平台可能自己购买过曲库,所以你在平台里面用一般没问题,不过也要看这首曲子许可的用途,商用和非商用是分开的。投稿时如果检测出来没有版权,有可能会被静音甚至封掉。
如果你是跨平台分发,就要考虑不同平台的曲库会不一样。因为我一开始想的就是多平台分发,所以选择了找公用的免费曲库:只挑许可允许配进视频的曲子,再按各自的许可在视频最后署名。
当配乐和音效制作完成,就可以把所有章节拼成一条全片审阅版,做最后的准备了。
成片放行:全片审阅
审片其实散在前面每一个阶段里:稿子、风格、静帧、整章动画,每一关除了我,还有 AI 在审,审动效的、核事实的、听声音的,各管一摊。
以我上一条视频里各个阶段为例,不同阶段审片重点也是不一样的:
| 阶段 | 看什么 | 在哪看 |
|---|---|---|
| 聊天里的样片 | 早期小样和分镜静帧 | 聊天窗口 |
| Blender 分段预览 | 节奏和构图 | 画布,低清预览 |
| 关键静帧 | 每格配台词和画面说明,逐格批注 | 画布 |
| 整章动画 | 拼好的整章视频,配一排抽帧 | 画布,720p |
| 全片审阅版 | 带旁白、音效、配乐 | 720p |
| 发布版 | 修完后导出 | 1080p,发布前又修了一处数据,导出过两版 |
前面审阅阶段结束后,在最后这一阶段,AI 会把所有章节拼成一条带旁白、音效和配乐的全片审阅版,我和 GPT(Codex 里的 Astra)各从头到尾看一遍,看的是整片连起来顺不顺,前后有没有对不上的地方,是否有明显的渲染异常,没问题就可以发布了。
还有一个要注意的点,在各阶段审片都要有一个地方把问题记下来并追踪任务进展,我之前就踩了这个坑,成片出完后,发现之前一个事实错误没有被修正,又回过头去做修改 + 渲染 + 审阅。
因此我用 Obsidian 的 Bases 搭了一张看板,一件事记录一条笔记,把状态、负责人、来源和产出都记录在上面,AI 会自动地帮我登记和销账,确保每一件事情都有落地。
看板上也记下我们做过什么。这样在做完一个片子之后,就可以回过头去看走了什么弯路,做了什么错事,工作量到底花在哪里了,后续再迭代这张表。
全篇审阅后,就可以发布了。
发布
AI 现在的 Computer Use(让 AI 直接操作电脑和浏览器)能力非常强了,因此现在想上传多平台这种繁琐的步骤,我会直接交给 AI,让它先去各大平台上传视频,再把标题、描述、视频章节填好,我只做最终的验收、修改和发布。封面我也是让 AI 制作,所以还是比较省事的。
总结
一张总表
到这里,短片和长片的做法都讲完了:短片一句话就够,长片按六个节点一关关往下推进。我这里最后把整个过程里的核心环节放在一起,再看一下每一环 AI 做什么、人要做什么:
| 环节 | AI 做什么 | 人要做什么 | 审阅节点 |
|---|---|---|---|
| 立项 | 整理资料、列候选题和标题 | 定讲什么、给谁看 | 立项 |
| 调研和写稿 | 调研、起草、按评论改 | 定主张和结构,写评论 | 剧本冻结 |
| 定风格 | 出几版试镜样片、画元素表、找候选配乐 | 选风格,确认元素 | 风格冻结 |
| 配音 | 合成、对出每句(能做到的话逐字)的时间 | 选音色、试听 | |
| 分镜 | 出关键静帧、排上画布 | 看每格的意思和稿子是否一致 | 关键静帧 |
| 动画和渲染 | 写动效、分段渲染、局部重渲 | 按章看动画和节奏 | 动画初版 |
| 配乐和音效 | 在给定曲库里选曲、排位置、挂音效 | 定曲库,听感把关 | |
| 拼接和审片 | 按时间轴拼接、混音;换一家模型挑错、登记问题 | 看、听、取舍 | 成片放行 |
| 发布 | 上传、填表、存草稿 | 改标题描述,点发布 |
回到开头那几个问题:46 分钟的视频,不算前面写博客的时间,制作视频这一段我花了约 20 个小时,Claude 自己跑了约 90 个小时,用掉 Max 20x 一周的额度;主力工具是 Obsidian 加 Claude Code,审稿和配音另用了 GPT 和 Gemini。表里「人要做什么」那一列,是我未来需要把控的部分:定讲什么、挑风格、审画面、做取舍,其余的交给 AI。
| 项目 | 数量 |
|---|---|
| 我花的时间 | 约 20 小时(只算做视频,不含写博客) |
| Claude 干活的时间 | 约 90 小时 |
| 我发的指令和批注 | 约 290 次(对话指令约 170 条,画布批注约 120 张) |
| 派出的子代理 | 53 个 |
| 模型调用 | 9,565 次 |
| 输入(不走缓存) | 约 2 万 token |
| 缓存写入 | 约 1.9 亿 token |
| 缓存读取 | 约 36.9 亿 token |
| 输出 | 约 1,307 万 token |
| 合计 | 约 38.9 亿 token |
| 按 API 标价折算 | 约 2,000 美元 |
| 按订阅分摊估算 | Max 20x 一周左右的额度,约 50 美元 |
附录
风险和合规
最后的最后,是关于风险和合规,上一条长视频和《刷新》这两部片子做下来,我还学习到了一些版权和合规问题。我按照制作环节整理了风险点,哪一步会碰到、要注意什么,做视频的时候可以交给 Agent 对一遍。
| 环节 | 风险 | 要注意什么 |
|---|---|---|
| 找参考 | 引用别人的作品 | 《著作权法》第二十四条允许为评论适当引用,但有限度,「图解电影」案用了 382 张剧集截图,被判赔 3 万元。下载的参考片只在自己电脑上拆,要在片子里放别人的片段,先问作者 |
| 找素材 | 图库不等于无版权 | Unsplash、Pexels、Pixabay 能商用,但认得出的人脸和商标不在许可里;再分发的限制三家各不相同,不能拿去搭自己的图库 |
| 找素材 | 肖像和 Logo | 画成线描,只要认得出是谁,仍然算肖像(《民法典》第一千零一十八条);在世的人可以用字母头像代替,品牌只写名字,不画 Logo |
| 找素材 | 工具和组件库 | Remotion 超过 3 人的公司要买授权,GSAP 不是 MIT,react-bits 在 MIT 上加了限制条款。代码能复制、仓库是公开的,不等于能随便商用 |
| 定风格 | 字体 | 优先用开源字体,比如思源黑体、思源宋体、霞鹜文楷、得意黑。方正家庭版不许用于网络视频;字体公司批量维权,单笔主张常在两三万元 |
| 定风格、分镜 | 地图 | 按《地图管理条例》和《地图审核管理规定》,自己画的中国或世界地图公开发布,通常要送审,示意图也不例外,发到境外平台也算;送审免费,约 20 个工作日,应送未送最高罚 10 万元。不画国界不等于免审,想省事,就直接用主管部门提供的带审图号的标准地图,按它的使用条件来 |
| 配音 | 声音克隆和 TTS 的许可 | 克隆谁的声音,要本人同意。开源模型的代码能商用,不代表权重能商用,F5-TTS 代码是 MIT,权重是 CC-BY-NC;剪映配音能导出,也不等于能商用 |
| 配乐 | AI 作曲的授权 | Suno 付费档按条款生成、从官方渠道下载的才能商用,Remix 一律不行;ElevenLabs Music 普通套餐排除电影、电视和广播用途,企业套餐另签,网络视频算不算用前要问清。没有一家承诺生成的曲子不会被版权系统认领 |
| 配乐 | 商单要另买授权 | 个人套餐能不能用在商单上,要看具体套餐,也要看是发在自己频道,还是交给客户投广告。影视飓风 2019 年分享过,当时 Musicbed 的频道授权约 500 元一个月,接商单要另买约 900 元一个月的 |
| 发布 | 标明 AI 生成 | 《人工智能生成合成内容标识办法》 2025 年 9 月起施行,只有旁白是 AI 配的也要标;抖音还会回头查历史投稿。AI 生成的原文件留档,重新编码可能丢掉元数据里的隐式标识 |
| 发布 | 署名 | 用了别人的素材、曲子、开源项目,按各自许可署名、保留版权声明;不强制署名的,也可以主动注明来源。何同学 2024 年在《我用 36 万行备忘录做了个动画》里把开源项目 ASCII generator 说成自己写的软件,还删了原作者署名,后来在评论区道歉。Agent 常常改开源代码来用,最好用一个记一个 |
| 发布 | 平台对 AI 自动化创作的限制 | 微信 2026 年 3 月在《微信公众平台运营规范》里新增「非真人自动化创作行为」:用 AI 脱离真实作者生成、改写、搬运内容,或用脚本批量发文,会被限流、删文甚至封号;官方的说法是鼓励用工具辅助,反对完全由程序代替真人。今日头条 2025 年处置低质 AIGC 内容超过 260 万条 |
参考资料
AI 视频作品和合集
- Awesome AI Motion:一千多条 AI 做的动画,按题材分类,可直接播放
- awesome-opus5-5-videos:七百多条 Opus 5.5 视频,附公开的提示词或原帖
- awesome-claude-5-5-videos:按制作路径整理的 Claude 视频案例和来源
- 比特新语(B 站主页):《刷新》对标的账号
- 有知有行《投资是怎样赚钱的?》(B 站):上一条视频的画面参考
- 毕导《不做诺奖科普的第一年,科普博主我还会做多久?》(B 站)
skill 和工具
- Lemo-Opuscar、Manim skill、Remotion skills、HyperFrames、Anatomy、Onetake、Anidoodle
- Claudian:在 Obsidian 里直接用 Claude Code
- Review Comments:Obsidian 里的批注插件
业界怎么做一条片子
- Kurzgesagt,How to Make a Kurzgesagt Video in 1200 Hours(官方视频,2020)
- 3Blue1Brown,官方工作流说明、官网 FAQ、Numberphile 播客文字稿、Dwarkesh 访谈、Dropbox 专访
- 影视飓风,《AI真的好用吗?影视飓风全新工作流分享!》(B 站,2026)、Tim 在汽车之家创作者大会的演讲精编(2025)
《刷新》用到的研究和数据
- Benartzi & Thaler, Myopic Loss Aversion and the Equity Premium Puzzle, Quarterly Journal of Economics, 1995
- Thaler, Tversky, Kahneman & Schwartz, The Effect of Myopia and Loss Aversion on Risk Taking: An Experimental Test, Quarterly Journal of Economics, 1997
- Tversky & Kahneman, Advances in Prospect Theory, Journal of Risk and Uncertainty, 1992
- Kenneth French, Data Library:美股日度回报,1926 年 7 月到 2026 年 8 月
- Morningstar, Mind the Gap 2025
正文表格里逐条链过的作品、配音和曲库价格页、版权和合规法规,这里不再重复。